PO28 - Gestione della Continuità Operativa
Politica Gestione della Continuità Operativa
Revisioni
| Rev. | Data | Descrizione | Redatto | Approvato |
| 0.0 | 24/04/2026 | Prima emissione | CISO | Amministratore Unico |
Introduzione
Scopo
Il presente documento definisce la politica per garantire la sicurezza delle informazioni in caso di scenari avversi, illustra cioè gli elementi in base ai quali impostare correttamente il sistema di gestione: analizzando scenari avversi, rispondendo organizzativamente e tecnologicamente in maniera efficace al loro verificarsi e ripristinando la situazione minimizzando i danni, salvaguardando il personale e l'immagine dell’Azienda.
Campo di applicazione
Quanto definito dal presente documento è applicabile a tutte le aree dell’Organizzazione coinvolte nel Sistema di Gestione Integrato.
Riferimenti e Allegati
ALPO01.A - Organigramma
MDPR18.1.G - Contatti di Emergenza
MDPR28.1.A - Piani di Continuità Operativa
MDPR28.1.C – Report Test di Continuità Operativa
PR28.1 - Gestione della Continuità Operativa.
Definizioni, Acronimi, Abbreviazioni
AdS – Amministratore di Sistema
BIA – Business Impact Analysis
CEO – Chief Executive Officer
CISO – Chief Information Security Officer
CO – Continuità Operativa
CTO – Chief Technology Officer
MTPD – Maximum Tolerable Period of Disruption
RPO – Recovery Point Objective
RTO – Recovery Time Objective
SGI – Sistema di Gestione Integrato.
Responsabilità
Il CISO ha la responsabilità di redigere, mantenere aggiornata e comunicare la presente politica.
Il personale, a qualsiasi livello, e i collaboratori esterni devono attenersi alle procedure definite dall’Organizzazione per assicurarsi che la presente politica sia correttamente applicata.
I responsabili dell’attuazione della presente politica sono:
-
Gli utenti, che devono riprendere le attività secondo le modalità previste dai piani
-
AdS, che deve effettuare le attività di ripristino e conduzione dei sistemi informatici e delle apparecchiature tecnologiche
-
Il Comitato di Crisi, unità composta da CTO, il CEO ed il Responsabile IT, che ha il compito di stabilire l’attivazione dei piani di continuità
-
I fornitori, che hanno il compito di supportare Vectorlab nelle attività di loro competenza.
Violazione della Politica
Qualsiasi azione non conforme alla politica aziendale dell’Organizzazione sarà considerata una violazione della sicurezza e come tale si tradurrà nella revoca dell'accesso alle aree e alle risorse informatiche, rete e documenti. L'uso improprio degli strumenti aziendali costituisce una grave violazione del dovere di correttezza e può comportare l'adozione di provvedimenti disciplinari in conformità alla normativa vigente.
I casi gravi saranno segnalati all'autorità competente e potranno essere oggetto di provvedimenti disciplinari o legali.
Riesame
La revisione di tale politica è effettuata dalla Direzione almeno una volta all'anno e prima del riesame della Direzione, e in risposta a cambiamenti significativi dell'ambiente organizzativo, del business, di riferimenti normativi o dell’ambiente tecnologico aziendale. Il riesame è condotto per valutare l'efficienza e l'efficacia del sistema e per assicurare che siano implementate le azioni necessarie per consentire il miglioramento continuo secondo i requisiti definiti dai sistemi di gestione e in tutte le situazioni per le quali è richiesta una modifica dell'attività aziendale che possa anche avere impatto sulla qualità e sulla sicurezza delle informazioni o sull'operatività.
Gestione della Continuità Operativa
Terminologia
La Continuità Operativa, o Business Continuity, è la capacità di un’Organizzazione di continuare a fornire prodotti e/o servizi a livelli accettabili a seguito di un grave incidente.
La Continuità della Sicurezza delle Informazioni o Information Security Continuity è l’insieme delle procedure e dei processi volti a garantire la continuità delle operazioni relative alla sicurezza delle informazioni.
Quest’ultima definizione stabilisce che, nell’ambito della sicurezza delle informazioni, è necessario occuparsi:
-
della riservatezza, integrità e disponibilità delle informazioni in qualunque formato e con opportune ridondanze,
-
della continuità dei processi di sicurezza delle informazioni, tra cui: controllo degli accessi, controllo degli archivi fisici e dei sistemi informatici, monitoraggio e gestione degli incidenti.
La Gestione della Continuità Operativa, o Business Continuity Management è un processo continuo che protegge il patrimonio aziendale sia in termini di infrastrutture tecniche a supporto del business, sia in termini di asset tangibili e no, al fine di garantire la continuità delle attività operative critiche e di assicurare i flussi degli introiti di business.
I Piani di Continuità Operativa, o Business Continuity Plan, descrivono il processo, le funzioni aziendali coinvolte e la valutazione di una strategia di recupero.
Nella loro rappresentazione gioca un ruolo fondamentale la definizione di quattro indicatori:
-
il Recovery Time Objective (RTO),
-
il Recovery Time Actual (RTA),
-
il Recovery Point Objective (RPO),
-
il Maximum Tolerable Period of Disruption (MTPD).
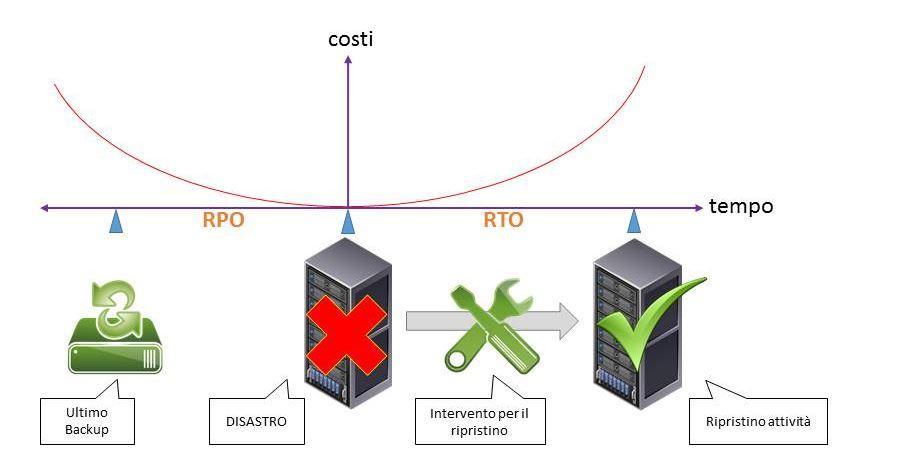
Il Recovery Time Objective (RTO), ovvero l’Obiettivo del Tempo di Ripristino di un sistema o di un processo organizzativo, indica il tempo necessario previsto per ripristinare l’operatività del sistema o del processo organizzativo, a partire dal verificarsi del disastro; il tempo di ripartenza dipende dal tipo di indisponibilità: del personale o dei servizi ICT. Un RTO pari a 0 significa che quel sistema o quel processo devono essere disponibili sempre e in modo continuativo.
Il Recovery Time Actual (RTA) indica il periodo di tempo effettivo trascorso per completare il ripristino dei dati e rendere disponibile la copia di archiviazione per l'accesso ad una applicazione. Mentre RTO è il valore stimato impostato come obiettivo, RTA è il tempo effettivo misurato rispetto ad esso. Per una buona governance e conformità dei dati, il RTA raggiunto deve essere inferiore al RTO stabilito nei piani di continuità (RTA \<= RTO). Quando si simula uno scenario simile al ripristino di emergenza in un ambiente di test (parallelo e indipendente dalla produzione) e si esaminano l'efficacia del proprio strumento di backup e ripristino, si misura il RTA verificando l’intervallo di tempo significativo tra il RTO stimato e il RTA effettivo.
Il Recovery Point Objective (RPO), ovvero l’Obiettivo del Punto di Ripristino, indica la quantità massima di dati o transazioni che è tollerabile perdere in caso di disastro: un RPO pari a 0 significa che non è consentita la perdita di nessun dato. In pratica con questo parametro si stabilisce dopo quanto tempo, dalla sua creazione o modifica, un dato debba essere salvato per evitarne la perdita o la corruzione. Per i sistemi informatici di fatto corrisponde al tempo tra un backup e l’altro, per le informazioni in altro formato corrisponde al tempo necessario alla loro copia e archiviazione in un luogo alternativo.
Anche i sistemi di replica in real time, o quasi, sono coinvolti nell’identificazione del valore di RPO che un sistema, un’architettura o un’infrastruttura può offrire.
Il Maximum Tolerable Period of Disruption (MTPD) indica il tempo massimo oltre il quale la mancata fornitura di prodotti e servizi o la non esecuzione di una attività diventa inaccettabile per l’organizzazione.
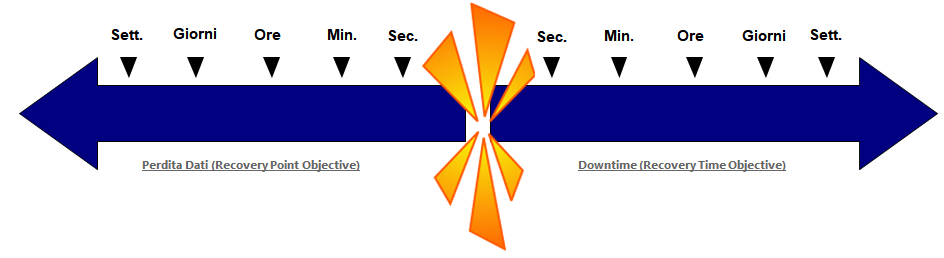
Il valore di RPO è strettamente legato alla struttura informatica, in quanto, salvo in rarissime eccezioni, il dato è al 99,99% su struttura informatica. Anche eventuali documenti cartacei firmati in calce manoscritti, sono in corso di sostituzione con quelli firmati digitalmente e per questo replicabili ovvero copiabili su diversi siti e supporti.
L’impatto di RTO ed RPO sul Business è rappresentabile nella seguente immagine:
Business Impact Analysis
Uno degli elementi fondamentali per garantire un'efficace continuità operativa è una chiara comprensione del livello di impatto che potrebbe avere un evento critico sul rilascio dei prodotti e sull’erogazione dei servizi offerti da Vectorlab. Questa comprensione guida la selezione delle strategie e soluzioni di continuità operativa più appropriate e la creazione dei relativi piani e procedure a supporto.
Tale attività è definita Business Impact Analysis (BIA) ed è il processo che, attraverso l’identificazione dei processi critici ed una ponderata valutazione degli impatti (economici, reputazionali, legali, operativi, ecc.) di eventi che possano compromettere la continuità di tali processi di business, fornisce una maggiore comprensione del funzionamento dell’Organizzazione. Inoltre, rivela gli effetti dell’interruzione di attività critiche, incluse quelle ICT, a supporto processi aziendali.
La BIA fornisce:
-
una chiara comprensione degli obiettivi strategici dell'Azienda
-
l’identificazione del tempo massimo di interruzione tollerabile (MTPD) per ciascun processo di business
-
informazioni sulle risorse per cui è possibile determinare quale sia la strategia di recupero più appropriata
-
uno schema delle dipendenze esistenti, sia internamente che esternamente, tra i vari processi e le attività ICT a supporto, che influenzano il raggiungimento degli obiettivi.
Gli obiettivi principali di una BIA sono:
-
dare priorità agli obiettivi aziendali
-
determinare quali sono i processi e le attività critiche dell'Azienda
-
determinare l'impatto delle interruzioni nel tempo
-
identificare i valori di RTO, MTPD e RPO relativi a processi e attività
-
determinare i tempi di ripresa di processi e attività a seguito delle interruzioni
-
fornire informazioni da cui è possibile determinare le strategie e le soluzioni di recupero più appropriate, anche attraverso la definizione di Piani di Continuità.
Definizione delle risorse (umane, strumentali)
La Gestione della Continuità Operativa investe diverse componenti e risorse strategiche di Vectorlab e dei clienti coinvolti: la Direzione, le strutture organizzative coinvolte nei processi di servizio, gli stakeholders rilevanti, le piattaforme tecnologiche impiegate. Ciò comporta che l’Organizzazione è chiamata a definire e coordinare un programma articolato in diverse fasi, che richiede il mandato dei vertici dell’Organizzazione stessa.
All’interno del processo sono identificati due ambiti e momenti diversi riguardo l’organizzazione delle attività e le relative responsabilità:
-
responsabilità durante le normali attività di gestione – normal state;
-
organizzazione a seguito di uno stato di crisi dichiarato – crisis state.
In entrambi i casi occorre determinare le competenze necessarie ed individuare il personale, interno o esterno, adatto per esperienza, formazione, istruzione.
La normale organizzazione identifica ruoli, responsabilità e autorità per un efficace e conforme funzionamento del SGI secondo quanto riportato nell’Organigramma aziendale (vedere “ALPO01.A - Organigramma”).
L’Organizzazione durante lo stato di crisi deve evidenziare responsabilità e, soprattutto, deleghe esplicite che consentono di affrontare la crisi con efficacia ed efficienza. Le responsabilità ed i ruoli durante lo stato di crisi sono temporanei e limitati alla gestione della situazione fino alla chiusura della crisi stessa.
Tutti i dipendenti devono essere a conoscenza delle procedure da mettere in atto per affrontare la condizione di disastro e/o emergenza in modo che possano continuare a fornire i servizi erogati anche durante l’evento disastroso.
Definizione delle soluzioni per la continuità
La Gestione della Continuità Operativa consente all’Azienda di:
-
migliorare la propria capacità di reazione a fronte di una interruzione nell’erogazione dei servizi;
-
disporre di un metodo deterministico per il ripristino della capacità di erogazione dei servizi ad un livello prestabilito e accettabile;
-
sviluppare la capacità di gestire l’interruzione del business (a fronte di un grave incidente) e proteggere la reputazione e l’immagine aziendale.
L’obiettivo principale è quello di prefigurare in anticipo situazioni di possibili scenari di degrado dei servizi forniti in modo da affrontare eventuali rischi legati ai processi, ai sistemi di supporto, nonché situazioni critiche che interessano un settore di business specifico, che si estendono a più aree di core business, o legati ad asset gestiti per conto di clienti. Ad esempio:
-
sistemi informatici: le soluzioni di continuità di questi, per situazioni di disastro, sono presenti nelle schede dei Piani di Continuità Operativa;
-
risorse umane: la disponibilità operativa del personale, soprattutto quello che ricopre ruoli chiave di tipo direttivo ed esecutivo, deve essere sempre garantita, se necessario anche con sostituti;
-
edifici e locali: luoghi alternativi devono essere presi in considerazione e identificati al fine di garantire un adeguato supporto logistico;
-
documentazione cartacea la cui protezione deve essere garantita quando non è disponibile un modulo elettronico: devono essere implementate regole e procedure per la protezione contro qualsiasi perdita o manomissione;
-
infrastrutture, servizi e beni come la disponibilità di acqua, elettricità, servizi di telecomunicazione: devono essere prese in considerazione soluzioni per gestire in modo efficiente qualsiasi indisponibilità;
-
fornitori: devono essere identificati quelli critici e i loro piani di continuità; preventivamente, se possibile, utilizzare due fornitori per i medesimi servizi o individuare fornitori alternativi da utilizzare in caso di necessità.
Definizione dei Piani di continuità operativa
Come risultato della BIA, individuate le attività di business più critiche dovranno essere definiti e redatti i Piani di Continuità Operativa, nell’ambito dei quali Vectorlab cerca di analizzare e ridurre le cause di rischio e aumentare i livelli di sicurezza delle proprie strutture, dettagliando le informazioni legate all'organizzazione logistica, dalla dichiarazione dell’emergenza al rientro alla normalità fino alle metodologie atte a riconoscere una situazione di crisi e far così fronte alla stessa.
Viene, inoltre, valutata la criticità dei servizi prevedendo strategie di ripristino: sito alternativo, metodologie e apparecchiature per il backup, ruoli e responsabilità delle figure coinvolte. Particolare attenzione è data alla definizione degli scenari di disastro in quanto il non tempestivo riconoscimento della gravità della situazione venutasi a creare può determinare anche un forte ritardo nella dichiarazione di emergenza e quindi maggiori difficoltà nella gestione della stessa.
Nell’individuazione e definizione dei Piani di Continuità Operativa, alcune ipotesi di scenari di emergenza/critici da analizzare possono essere:
-
Inagibilità parziale e/o totale dei locali per eventi avversi quali incendio, terremoto, allagamento, atmosferici, sociali o sanitari;
-
Connettività non disponibile;
-
Assenza di alimentazione elettrica;
-
Servizi cloud non disponibili;
-
Infrastruttura locale non disponibile / Servizi ICT non disponibili;
-
Cyberattacchi;
-
Indisponibilità del personale: mancanza di personale o di competenze temporanee o permanenti;
-
Indisponibilità dei fornitori critici;
-
Distruzione degli archivi cartacei.
Per l’implementazione di un Piano di Continuità Operativa è importante includere soluzioni:
-
logistiche: definendo processi, comportamenti e sedi alternative,
-
organizzative: stabilendo ruoli, responsabilità, attribuendo compiti e definendo una lista dei contatti (inclusi possibili sostituti) da chiamare in caso di necessità,
-
tecnologiche: individuando le attrezzature tecniche di supporto,
garantendo sempre i processi di sicurezza delle informazioni: controllo accessi, controllo degli archivi fisici e dei sistemi informatici, monitoraggio, gestione degli incidenti.
Ogni Piano di Continuità riporta le attività dettagliate da eseguire raggruppate in 5 fasi; ogni fase rappresenta un passo nel piano di ripresa delle operazioni.
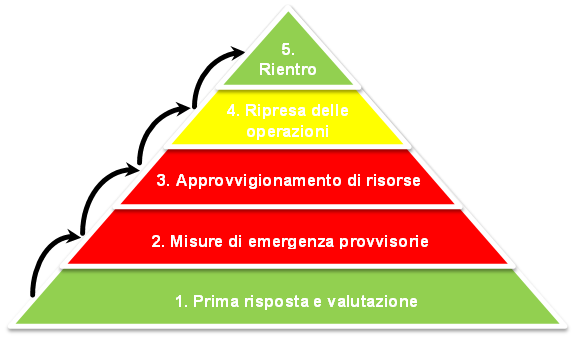
1) Fase 1 – Prima risposta e valutazione: intraprendere ogni azione immediata a seguito di un incidente, valutare l’impatto dell’incidente sulle attività.
2) Fase 2 – Misure di emergenza provvisorie: attuare misure a breve termine per limitare l’impatto dell’incidente (come, ad esempio, trasferire le attività dello staff in un altro luogo o fare in modo che il personale chiave lavori da casa).
3) Fase 3 – Approvvigionamento di risorse: fornire le risorse minime necessarie per riprendere le operazioni in una località alternativa (come scrivanie, telefoni, computer, stampanti, server, connettività, ecc.).
4) Fase 4 – Ripresa delle operazioni: riprendere ad un livello accettabile l’operatività nella località alternativa; può richiedere il trasferimento del personale, la ricreazione di dati perduti, l’elaborazione degli arretrati, ecc.
5) Fase 5 – Rientro: completare tutte le azioni necessario per risolvere l’incidente, trasferimento del personale nella sede originale e ripresa della normale attività.
A seconda della natura e della durata dell’incidente, si può tornare alla normalità senza eseguire le fasi 3 e/o 4 (o riducendole al minimo come durata ed estensione).
Nel Piano di Continuità Operativa vengono quindi individuate e analizzate le eventuali minacce e le contromisure logistiche, organizzative e tecnologiche da adottare, nonché le procedure di eccezione, compresa l’organizzazione e la sua formazione, la loro verifica e il miglioramento del piano sulla base dei risultati e dei possibili cambiamenti interni ed esterni. È pertanto essenziale che la BIA permetta di:
-
identificare le risorse e i processi aziendali critici per il loro ruolo core;
-
valutare l'impatto che un'improvvisa interruzione di tali servizi chiave a seguiti dei rischi sopra elencati può avere sull'attività operativa quotidiana;
-
quantificare le tempistiche ed il livello di indisponibilità delle risorse che risultino inaccettabili.
È altresì fondamentale effettuare il monitoraggio continuo dell'efficacia del sistema implementato attraverso test di piani, simulazioni, audit periodici ed evidenza di tali attività.
L'implementazione del Piano di Continuità Operativa segue un processo composto dalle seguenti fasi:
1) Pianificazione – Organizzazione, processi, procedure e attrezzature tecnologiche necessarie per pianificare un sistema in grado di garantire la continuità aziendale nei tempi o livelli di servizio definiti.
2) Implementazione – Particolare attenzione va posta alla comunicazione, alla sensibilizzazione e alla formazione specifica di tutti gli utenti sulle procedure e sui piani da attuare.
3) Monitoraggio – Continua verifica dell'efficacia del sistema implementato attraverso l’esecuzione dei test dei piani di continuità, le simulazioni, gli audit periodici con la raccolta delle evidenze di tali attività.
4) Miglioramento continuo – Coinvolge l'evoluzione del sistema in relazione ai feedback provenienti dal monitoraggio e da eventuali nuovi requisiti interni ed esterni. Non conformità daranno quindi luogo ad azioni correttive, nella logica del miglioramento continuo su cui la materia si fonda (Ciclo di Deming: Plan-Do-Check-Act).
La definizione di ciascun Piano di Continuità Operativa avviene in accordo con la procedura “PR28.1 - Gestione della Continuità Operativa”.
Ogni piano è declinato in un singolo documento, predisposto secondo il modulo “MDPR28.1.A - Piani di Continuità Operativa”.
Pianificazione
Le situazioni critiche che possono verificarsi sulla continuità aziendale sono identificate e descritte nella “PR28.1 - Gestione della Continuità Operativa” che definisce le procedure semplici e schematiche utilizzabili da tutte le risorse coinvolte attraverso l’identificazione di scenari, implementati a loro volta nel documento “MDPR28.1.A - Piani di Continuità Operativa” (uno per ogni piano).
Il personale deve essere informato e preparato a reagire correttamente alle situazioni identificate.
Implementazione
L’addestramento, la diffusione e la comunicazione dei piani di Continuità Operativa devono essere implementati in modo da garantire l’efficacia e la tempestività delle azioni intraprese. Per questa fase vengono identificate le persone coinvolte, viene definito quando un incidente deve essere gestito come tale o devono essere attivati i piani di continuità. Il fattore tempo è sempre un fattore discriminante. Deve essere redatta la lista dei contatti “MDPR18.1.G – Contatti di Emergenza” e deve essere definito chi ha il potere di richiedere l’attivazione dei suddetti piani. Chiunque rileva un evento per cui potrebbero essere attivati i piani deve segnalarlo al CISO.
I piani devono essere definiti dando priorità alla salute e sicurezza delle persone.
Monitoraggio
La pianificazione e l'esecuzione dei test e delle esercitazioni rappresentano una fase molto importante e obbligatoria. Queste garantiscono la coerenza dei vari livelli dei piani di continuità operativa nel tempo, come descritto in procedura “PR28.1 - Gestione della Continuità Operativa”. Si possono condurre diversi tipi di test:
-
test a tavolino: riesame collettivo dei piani di continuità da parte del personale coinvolto,
-
simulazioni con personale preavvertito,
-
simulazioni con personale non preavvertito.
Un test può essere svolto anche in concomitanza di un evento reale.
I test devono essere pianificati secondo una precisa frequenza o effettuati test straordinari a seguito di modifiche significative all’Organizzazione o ai sistemi informatici (vedere “MDPR28.1.C – Report Test di Continuità Operativa”).
Miglioramento continuo
Eventuali errori o cambiamenti al fine di migliorare i piani emersi durante i test o la diretta applicazione dei piani dovranno essere presi in carico immediatamente. I piani e le informazioni ad esso connesse devono essere aggiornati costantemente (es: lista dei contatti “MDPR18.1.G – Contatti di Emergenza”).
Ridondanza
Al fine di garantire la continuità della sicurezza delle informazioni, si deve prendere in considerazione la ridondanza degli apparati.
Descrivere se e che cosa viene ridondato XXX